Crivo
O Crivo classifica e-mails corporativos como produtivos ou improdutivos e rascunha uma resposta quando o e-mail pede uma. Modelos do Hugging Face rodam por trás de um back-end em FastAPI, e um dashboard em Next.js mostra os resultados e o histórico de todos os e-mails processados.
Fiz sozinho em seis dias.
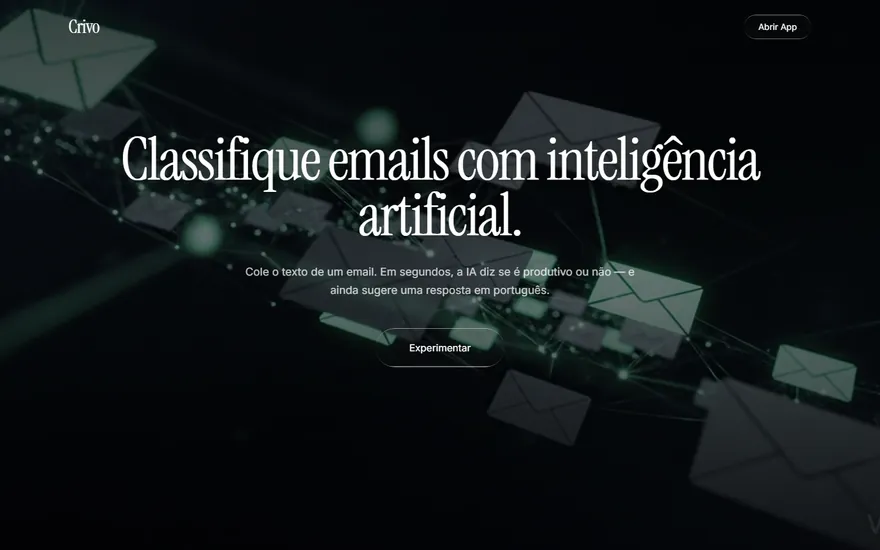
O problema
A AutoU pediu essa aplicação no processo seletivo. Montei a demonstração em torno de uma equipe financeira cuja caixa de entrada mistura pedidos de clientes com avisos de banco, newsletters e alertas de sistema, e publiquei no plano gratuito do Render para os avaliadores testarem sem instalar nada.
Decisões
Inferência remota em vez de modelo local
O plano gratuito do Render dá 512 MB de RAM ao back-end, e rodar o bart-large-mnli no mesmo processo exige cerca de 1,6 GB, então chamei a Hugging Face Inference API em vez de carregar o modelo. O custo é o cold start em duas frentes: o modelo hospedado pode responder 503 enquanto carrega, o que o back-end transforma em mensagens de erro em português (o mesmo vale para timeout), e o Render coloca o back-end para dormir quando fica ocioso, o que a tela de aquecimento resolve.
Rótulos em inglês para e-mails em português
Testei o multilíngue xlm-roberta-large-xnli e voltei para o bart-large-mnli no mesmo dia, porque ele dava confiança menor em e-mails que eram pedidos óbvios de ação. Mantive rótulos e template de hipótese em inglês e, quando os rótulos antigos ‘productive’/‘unproductive’ jogaram newsletters na classe produtiva, reescrevi os rótulos para descrever o e-mail (‘a direct request requiring action’ contra ‘informational or promotional content’).
Respostas por LLM com plano B determinístico
Uma resposta gerada fica melhor que um template, mas uma chamada externa a um LLM pode falhar ou estourar o tempo, então qualquer erro cai no motor de templates e o usuário recebe um rascunho mesmo assim. E-mails marcados como automáticos nem passam pelo LLM e recebem uma ação interna, porque não há ninguém do outro lado para ler a resposta.
O que eu fiz
- Um serviço FastAPI dividido em módulos de extração, classificação, métricas, seed e health, sobre PostgreSQL com SQLAlchemy 2.0 assíncrono e asyncpg, e o esquema controlado por migrações no Alembic.
- Um endpoint de lote que transmite o progresso por Server-Sent Events e grava cada resultado no banco assim que fica pronto. Como o EventSource do navegador não envia POST, o front-end lê o stream da resposta do POST com TextDecoderStream e interpreta os eventos por conta própria.
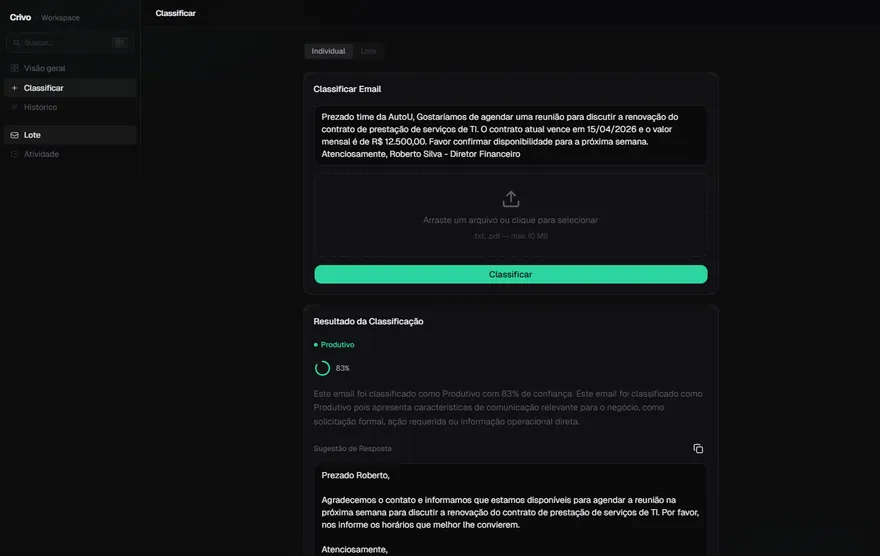
- Um fluxo de resposta: o Qwen2.5-72B-Instruct, pela API de chat completion da Hugging Face, escreve uma resposta curta em português ligada ao conteúdo do e-mail. Quando essa chamada falha, um motor de templates em Python escolhe o modelo pelo subtipo e preenche com os valores, datas, primeira linha e o nome da saudação extraídos do texto.
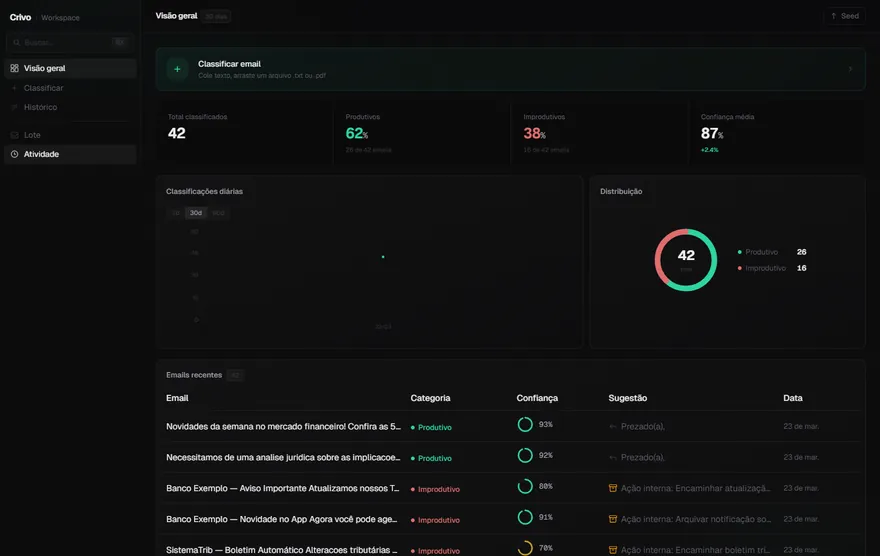
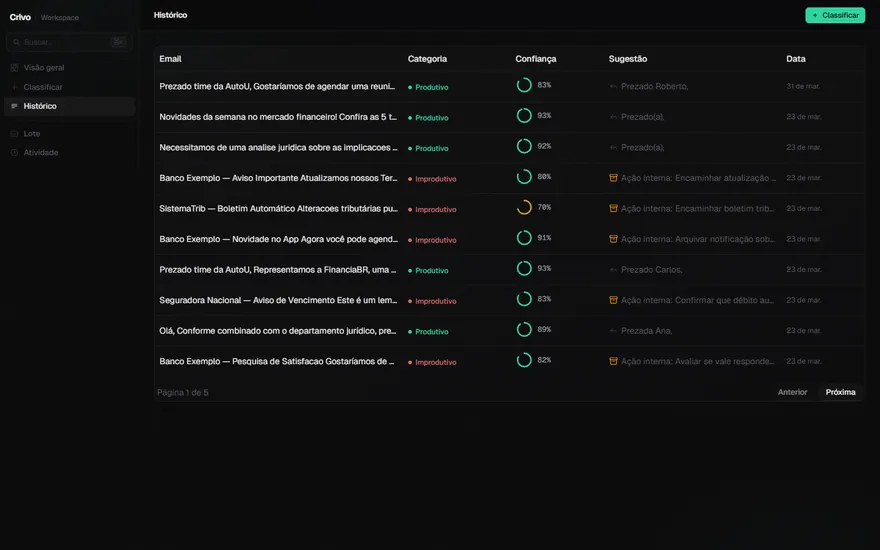
- Uma aplicação em Next.js 16 e React 19 com as páginas Visão geral, Classificar e Histórico, feita com hooks do TanStack Query, shadcn/ui, um gráfico diário em Recharts, um donut em SVG e anéis de confiança em SVG.
- Uma tela de aquecimento que consulta o endpoint de health, com novas tentativas em backoff exponencial de até 10 segundos, enquanto o Render acorda o back-end. Um endpoint de seed limpa as tabelas e carrega 40 e-mails de exemplo em português, já classificados e distribuídos em 30 dias, para o dashboard ter dados logo na primeira visita.
Como funciona
Um front-end em Next.js conversa com um back-end em FastAPI via REST. O e-mail entra como texto colado ou como arquivo .txt ou .pdf de até 10 MB. Os arquivos passam antes por um endpoint de extração, que lê PDFs com pypdf e decodifica arquivos de texto em UTF-8, com Latin-1 como alternativa. Depois, o texto vai para o facebook/bart-large-mnli na Hugging Face Inference API para classificação zero-shot, e o rótulo vencedor vira Produtivo ou Improdutivo, com o score de confiança e uma explicação fixa para cada categoria.
Em seguida, um código baseado em regras procura frases de mensagem automática, como “não responda este email”, escolhe um subtipo (solicitação, proposta, reclamação, agendamento, negociação, notificação, newsletter) pela contagem de palavras-chave e extrai valores em R$, datas e percentuais com regex. E-mails que pedem retorno recebem um rascunho de resposta do Qwen2.5-72B-Instruct. Os automáticos recebem uma ação interna, como arquivar um extrato na pasta de conciliação. Cada e-mail e sua classificação ficam salvos em duas tabelas no PostgreSQL, via SQLAlchemy assíncrono.
No modo lote, o front-end envia uma lista de textos para um endpoint que responde com Server-Sent Events: um evento por e-mail e, no fim, um evento de resumo com totais e confiança média. O dashboard lê total, divisão por categoria, confiança média e série diária de um endpoint de métricas que faz a agregação em SQL, e a página de histórico pagina as mesmas tabelas.
Tecnologias
- Front-end
- Next.js 16, React 19, TypeScript, Tailwind CSS v4, shadcn/ui, TanStack Query v5, Recharts v3, react-dropzone, Sonner
- Back-end
- Python, FastAPI, Uvicorn, Pydantic v2 (pydantic-settings), SQLAlchemy 2.0 (assíncrono), Alembic, pypdf
- IA
- Hugging Face Inference API (huggingface_hub AsyncInferenceClient), facebook/bart-large-mnli (zero-shot), Qwen/Qwen2.5-72B-Instruct
- Dados
- PostgreSQL, asyncpg
- Infraestrutura
- Render (front-end, API e banco de dados no plano gratuito)
- Ferramentas
- pnpm, ESLint